Worum geht’s
Wer Kubernetes betreibt, kennt den Moment: Ein Node muss weg, etwa weil eine Spot-Instanz reclaimed wird oder ein Kernel-Patch ansteht. Kubernetes beendet dann den Pod und startet ihn woanders neu. Für einen Gameserver mit fünfzig Spielern heißt das: Alle fliegen raus.
Paguro ändert das. Es migriert laufende Pods live auf einen anderen Node, mit Memory, Volumes und sogar offenen TCP- und UDP-Connections. Die Anwendung steht für einen Augenblick still und läuft dann einfach weiter.
In einfachen Worten
Stell dir ein volles Restaurant vor, das in ein anderes Gebäude umziehen muss. Kubernetes setzt alle Gäste vor die Tür, eröffnet woanders neu und hofft, dass sie wiederkommen. Paguro zieht das Restaurant samt Gästen um: Jeder sitzt am selben Tisch, das Essen steht noch da, das Gespräch geht weiter. Für einen Wimpernschlag flackert das Licht. Mehr merkt niemand.
Erst die Demos
Erst beim Abspielen wird das Video von YouTube geladen (Google). Datenschutz · Auf YouTube ansehen
Erst beim Abspielen wird das Video von YouTube geladen (Google). Datenschutz · Auf YouTube ansehen
So einfach wird migriert:
# einen einzelnen Pod gezielt migrieren
kubectl paguro migrate <pod> -n <namespace> --to <node> --wait

# oder den Node drainen: migrierbare Pods werden migriert statt neu gestartet
kubectl drain <node> --ignore-daemonsets
Wie Paguro funktioniert
Der Trick: Der Pod auf dem Target-Node ist ein ganz normaler Pod. Ein 2,7 MB kleiner Wrapper um runc macht aus seinem runc create ein runc restore. kubelet und containerd merken davon nichts, am Runtime-Stack des Nodes ändert sich nichts.
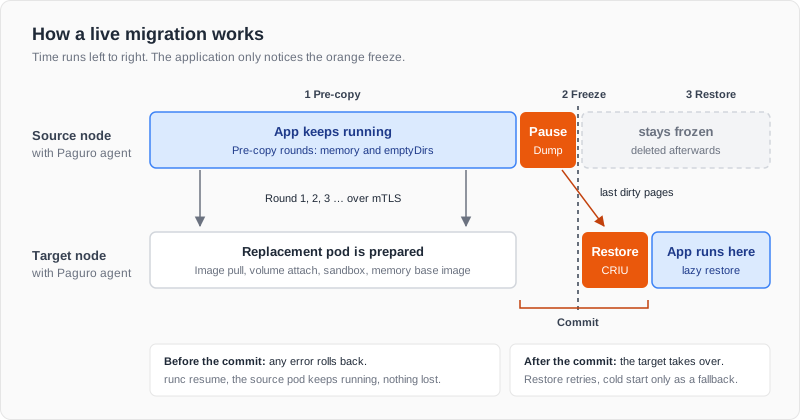
- Pre-Copy: Die Anwendung läuft weiter, während das Memory in Runden kopiert wird, ab der zweiten Runde nur noch die geänderten Pages.
- Freeze und Commit: Der Container wird pausiert, der letzte Rest übertragen. Bis zum Commit endet jeder Fehler in einem Rollback.
- Restore: CRIU startet den Prozess auf dem Target, fehlende Pages kommen per
userfaultfdnach.
Die fünf härtesten Probleme
Die Idee ist einfach, die Umsetzung nicht. An diesen fünf Problemen scheitert Live-Migration normalerweise.
1. Ein einziges Paket kann alles zerstören
Trifft eine TCP-Retransmission den Target-Pod, bevor sein Socket wiederhergestellt ist, antwortet der Kernel mit einem RST, und ein einziger RST beendet die Connection endgültig. Paguros RST-Shield setzt deshalb in jeden neuen Network Namespace eine nftables-Drop-Rule, noch bevor die CNI läuft. Selbst ein Race von wenigen Millisekunden beim Anlegen der Namespaces ist abgefangen: 0 Fehler bei 500 Versuchen.
2. Die IP mitnehmen: von 55 auf 0,6 Sekunden
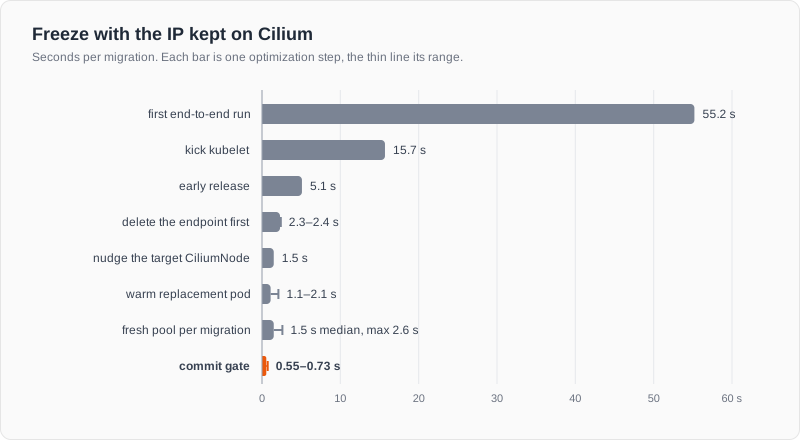
Hinter jedem Balken steckt ein Mechanismus aus Cilium oder kubelet, den ich erst im Quellcode gefunden habe. Ein Beispiel: kubelet versucht eine fehlgeschlagene Sandbox nur einmal pro Sekunde erneut. Meine erste Idee war, den Freeze genau auf diesen Takt abzustimmen. Klang logisch, war im A/B-Test aber langsamer: 1.731 statt 1.510 ms. Also flog sie raus. Funktioniert hat ein anderer Weg: Paguro bindet den Ersatz-Pod erst im exakt richtigen Moment an den Node, denn der allererste Sync eines Pods wartet nicht auf diesen Takt. So lief das ganze Projekt: Jede Idee wird gemessen, und was die Zahlen nicht besser macht, kommt nicht rein.
Warum jede Millisekunde zählt: TCP wiederholt verlorene Pakete nach etwa 0,2, 0,6, 1,4 und 3,0 s. Ein Freeze von 1,12 s kostete den Client deshalb 1,45 s, einer von 1,60 s schon 3,16 s.
3. Speicher, der sich schneller ändert, als man ihn kopieren kann
Pre-Copy kopiert das Memory, während die Anwendung weiterschreibt. Bei einem Pod mit 8 GiB schrumpften die Runden von 8.194 MiB auf 4 MiB, der Freeze lag bei 1,59 s für 8 GiB. Beim Restore war CRIU der Engpass: 1,87 s für 1 GiB. Mit einem 13-Zeilen-Patch für CRIU und Lazy Pages sind es jetzt 104–146 ms.
4. CPUs, die nicht gleich sind
Ein Python-Prozess, auf einer neueren CPU gestartet und auf eine ältere migriert, crashte direkt nach dem Restore: glibc hatte beim Start Instruktionen gewählt, die es auf der älteren CPU nicht gibt. Paguro gibt jedem migrierbaren Pod deshalb eine CPU-Baseline, auf die glibc, Go, die JVM und Co. von Anfang an begrenzt sind. Seitdem migriert derselbe Prozess in 326 ms, in beide Richtungen.
5. Phantom: neue Adresse, gleiche Verbindung
Normalerweise nimmt ein Pod bei Paguro seine IP-Adresse mit, so wie man beim Umzug seine Telefonnummer behält. Das hat zwei Haken: Die Übergabe der Adresse kostet Zeit, und zwar genau im Freeze. Und viele Netzwerke, etwa Flannel, Antrea oder das AWS VPC CNI, können Adressen gar nicht zwischen Nodes verschieben.
Phantom löst beides. Der Pod bekommt am neuen Ort eine neue Adresse, und Paguro sorgt dafür, dass seine Gesprächspartner davon nichts merken. Das funktioniert wie ein Nachsendeauftrag bei der Post, nur in Echtzeit und in beide Richtungen: Wer weiter an die alte Adresse schreibt, erreicht den Pod an der neuen, und seine Antworten tragen weiter den alten Absender. Die alte Adresse gehört niemandem mehr, sie lebt nur noch als Phantom weiter. Daher der Name.
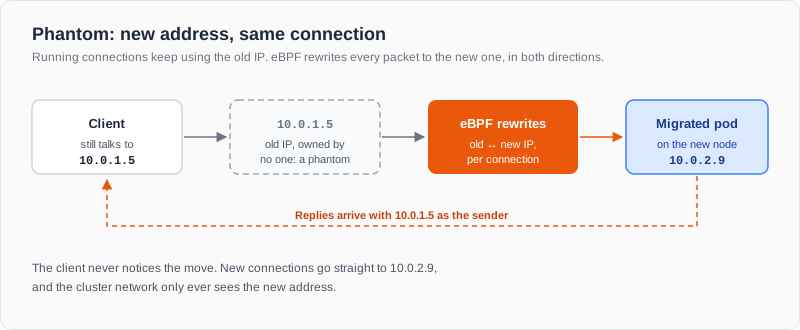
Technisch übernehmen das kleine eBPF-Programme im Network Namespace des Pods. Sie schreiben jedes Paket einer laufenden Connection zwischen alter und neuer IP um, exakt pro Verbindung, während neue Verbindungen direkt an die neue Adresse gehen. Weil der neue Pod schon vor dem Freeze komplett bereitsteht, sinkt der Freeze auf 0,3–0,9 s. Damit funktioniert Live-Migration auch auf Netzwerken, die IPs gar nicht verschieben können.
Vier CNIs, ein Ergebnis
Jede CNI hatte ihre eigene Falle, von Ciliums eBPF-Load-Balancer bis zum Open vSwitch von Antrea. Nach den Fixes geht keine einzige Connection mehr verloren, egal ob der Client die Pod-IP, den Service oder einen NodePort von außen nutzt:
| CNI | Verlorene Connections | Freeze |
|---|---|---|
| Flannel | 0 | 338–635 ms |
| Cilium | 0 | 339–491 ms |
| Antrea | 0 | 354–609 ms |
| Calico | 0 | 356–904 ms |
Die Königsdisziplin: Gameserver
Gameserver haben kein Failover: Spieler schicken über UDP 30 Inputs pro Sekunde, der Server hält ihre Sessions im Memory. UDP brachte vier eigene Fallen mit, die Paguro alle entschärft. Im Test mit fünf Migrationen direkt hintereinander gingen Inputs nur während des Freeze von 0,6 s verloren, es gab keinen Session-Reset, und alle 625 neu joinenden Spieler kamen rein.
Der Praxistest mit Minecraft Java (TCP) und Minecraft Bedrock (UDP), je acht Bots, die spielen und chatten. Auf allen fünf Clustern verlor kein einziger Spieler die Verbindung:
| Cluster | Freeze Java (TCP) | Freeze Bedrock (UDP) |
|---|---|---|
| Cilium (Lab) | 1,1 / 1,75 s | 0,77 / 0,85 s |
| Calico (Lab) | 1,9–2,7 s | 1,45–1,57 s |
| Flannel (Lab) | 1,3 / 1,5 s | 0,48 / 0,51 s |
| Antrea (Lab) | 1,2 / 4,0 s | 0,53 / 0,53 s |
| Amazon EKS | 0,61 / 0,66 s | 0,44 / 0,47 s |
Storage, Cloud und Chaos
Volumes ohne Datenverlust. Auch die Daten des Pods ziehen mit um. Paguro kopiert sie schon vorab, im Freeze kommt nur noch dazu, was sich zuletzt geändert hat. Im Härtetest zog ein 25-GiB-Volume um, auf das alle 100 ms geschrieben wurde: Kein einziger Eintrag fehlte.
Cloud, Karpenter und Spot. Wird ein Node geleert, etwa durch Karpenter oder eine Spot-Unterbrechung, migriert Paguro die Pods automatisch, statt sie neu zu starten:
| Disruption | Ergebnis |
|---|---|
| Drift (neuer Node zuerst, dann Drain) | 651 ms Freeze, 0 Disconnects |
| Drift von On-Demand auf Spot | 549 ms Freeze, 0 Disconnects |
| NodeClaim gelöscht | 531 ms Freeze, 0 Disconnects |
| Spot Interruption Warning | 0,53–0,70 s Freeze, fertig bevor AWS die Instanz beendet |
Chaos-Tests. Ein Testskript killt Controller und Agents mitten in der Migration. Jeder Run endete entweder in einem sauberen Rollback oder in einer erfolgreichen Migration, nie mit einem doppelten oder eingefrorenen Pod. Sogar ein helm upgrade mitten in einer Minecraft-Migration lief ohne Disconnect durch.
Was Paguro heute kann
- Live-Migration von Memory, Dateien und Volumes
- IP-Erhalt auf Cilium und Calico, Phantom für alle Netzwerke, die IPs nicht verschieben können (Flannel, Antrea, AWS VPC CNI und weitere)
- automatische Migration bei
kubectl drain, Karpenter, Cluster Autoscaler und Spot-Unterbrechungen - Agones-Integration für Gameserver
- verschlüsselte Übertragung zwischen den Nodes, Installation per Helm-Chart
Key Learnings
- Measure, don’t assume. Ich hielt das 1-GbE-Kabel für den Engpass. Ein 10G-Direktlink zeigte: Auch zwei VMs auf demselben Host schaffen nur 5–6 Gbit/s. Der Engpass war die Virtualisierung, nicht das Kabel.
- Optimiere auf das, was der User spürt. Nicht der Freeze zählt, sondern wie lange der Client wartet. Deshalb misst Paguro immer auch beim Client.
- Mach stille Fehler laut. Seit Go 1.24 öffnet jeder Go-Server MPTCP-Sockets, die CRIU nicht migrieren kann. Paguro erkennt das heute vor dem Freeze und sagt klar, was zu tun ist.
Du betreibst Gameserver, Spot-Flotten oder Jobs, die keinen Restart vertragen? Dann lass uns austauschen: david@picillo.de